K8s 晚安故事書
十一個章節,每章三層:五歲小孩聽得懂的故事、值班老手看了會笑的插圖,以及這個概念在 production 讓我付出的代價。
English version: A Kubernetes bedtime story
童書常常用很短的句子講很大的道理。《好餓的毛毛蟲》講的是變態發育,但唸給小孩聽的人從來不用說出這個詞。Kubernetes 也值得這樣講,因為它整個設計就是同一個想法一直重複:每個 object 存在,都是因為前一個 object 留下了一個洞。 Pod 會死,所以有 Deployment;Deployment 的 Pod 會換地址,所以有 Service。順著這條線拉下去,YAML 就不再像是一堆隨機的欄位。
這篇把這條線講成睡前故事。每章分三層,讀到哪一層停下來都可以:
- 故事。 短到可以唸給五歲小孩聽。
- 插圖。 精確到可以拿去做 review,裡面藏了幾個給半夜被 page 過的人的梗。
- 給大人的。 這個概念在真實平台上長什麼樣子:5 個 AWS account、3 個 region、每天 4–5 百萬個 request。事故是我自己的,學費是真的付過的。
章節順序和「一個問題換來一個新東西」的講法,來自 Akhilesh Mishra 的十一篇系列,值得整串讀完;每章最後附原文連結。故事、圖、production 筆記和更正是我寫的。
圖裡的標籤用英文,因為那些本來就是你在
kubectl裡會看到的字。
第一章:一棟大房子、很多小房子,和一位管家
故事。 從前從前,所有程式都住在同一棟大房子裡。廚房一淹水,整棟一起停電。所以大家改蓋很多小房子,一個工作一間。這下淹水只會淹一間。可是小房子倒了誰會發現?有人搬家了誰去通知鄰居?後來來了一位管家,倒了就重蓋、客人多了就加蓋、每條街都給一個不會變的名字。他叫 Kubernetes。
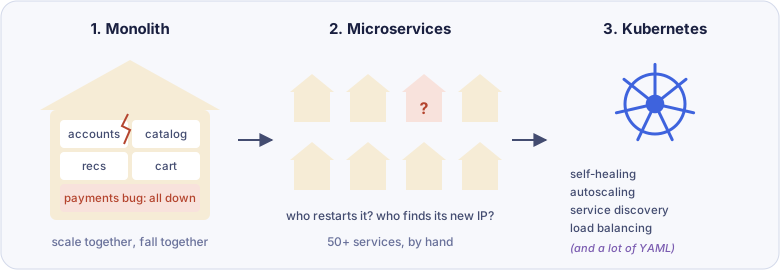
給大人的。 原文講了一件很多入門文章會跳過的事:不是每樣東西都該上 Kubernetes。我在 E2 Nova 負責的平台上,SIP 和 RTP 語音服務一直留在 EC2 + Auto Scaling group。Container 網路處理大範圍 UDP port 並不優雅,而且電信商的防火牆白名單綁的是一整池 Elastic IP、每台 node 一個,這是 ASG 的形狀,不是 Kubernetes 的形狀。migration switcher 要獨立出來時,我放在 ECS 而不是 EKS:一個單一用途、沒有鄰居的服務,從 Kubernetes 生態系拿不到任何好處,只會多一份維運成本。真正上 EKS 的是 stateless 的後端服務,那是 Kubernetes 明顯贏的地方。看 workload 決定,不是預設全上。
原文:Stop over-complicating Kubernetes
第二章:大家都只跟前台說話
故事。 管家家裡有一個前台,誰都不能繞過去。你先說你是誰,前台檢查你能不能做這件事,才把它寫進大本子裡。前台後面,有一個盯場的人整晚對照本子和真實世界,還有一個派工的人決定每位客人睡哪一間。
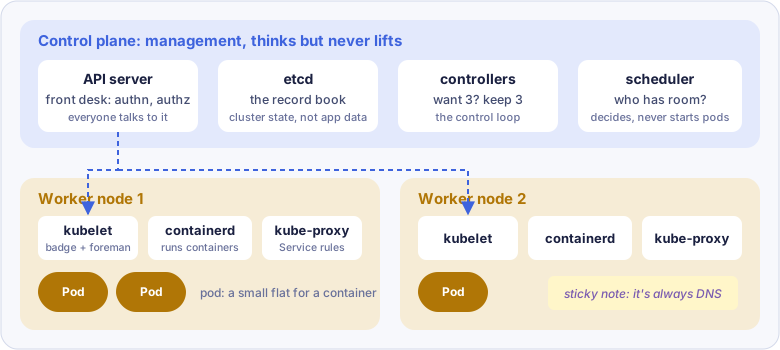
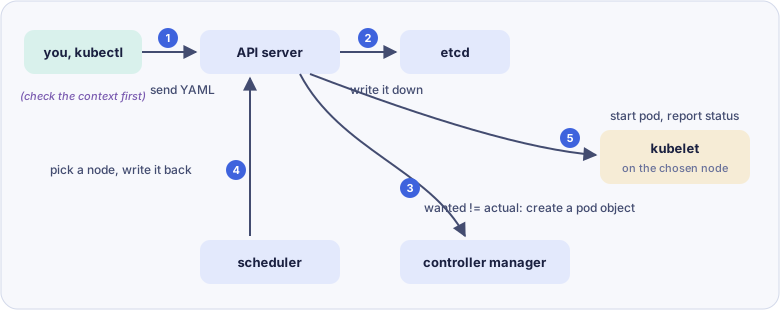
Scheduler 從來不直接打給 worker。它把決定寫回 API server,被選中那台 node 上的 kubelet 自己來拿。只有這一條路,所以一致性、授權和 audit log 都能在同一個地方管。
給大人的。 前台要分得出誰是誰才有用。我接手 EKS 叢集時,團隊用同一組 long-lived IAM access key 登入,CloudTrail 裡每一個 kubectl 動作都是同一個身分,誰做了什麼根本說不清楚。我分三步改:共用 key → aws sts get-session-token(暫時性,但呼叫 STS 還是要 long-lived key)→ aws sso login,MFA 由 IdP 強制。從那之後,叢集裡每個動作都有一個人的名字。API server 一直都在檢查身分,只是我們什麼都沒給它分辨。
原文還有一句值得再講一次:base64 不是加密。 能讀 Secret 的人就能解開它。
原文:Building your first real Kubernetes application
第三章:數羊
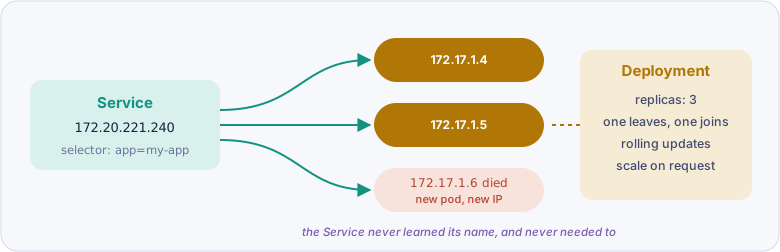
故事。 這一章要像數羊一樣數。有個 Pod 睡著了再也沒醒,所以 Deployment 答應永遠保持三個醒著。Pod 一直換房間,所以 Service 給它們一扇掛名牌的門。有個 Pod 醒著但一直盯著牆,所以小夜燈會檢查誰真的準備好了。就這樣一隻一隻數,數到你睡著。
- Pod 跟著 node 一起死,沒人把它叫回來 → Deployment
- 新 Pod 新 IP,呼叫的人找不到 → Service,用 label 找人
- Pod 在跑但卡住,還一直收流量 → liveness 和 readiness probe
- 十個 LoadBalancer Service,十張帳單 → Ingress
- Ingress 只是規則 → Ingress controller
- 設定寫死在 image 裡 → ConfigMap
- 密碼放在 ConfigMap → Secret,加上 encryption at rest 和權限控制
- 一個 Pod 吃光整台 node → requests 和 limits
- 半夜 100 人、中午 10,000 人 → HPA
- HPA 加了 Pod,node 卻滿了 → Karpenter
- Postgres 重啟,資料不見 → PersistentVolume
- 每顆硬碟都要人手動開 → PVC 和 StorageClass
- 三份 DB 擠同一顆硬碟 → StatefulSet
- 三份一樣的 YAML 慢慢長得不一樣 → Helm
- 大家都擠在
default→ Namespace - Namespace 只是紙上的牆 → RBAC
- 一個團隊壓測,其他人排不進去 → ResourceQuota 和 LimitRange
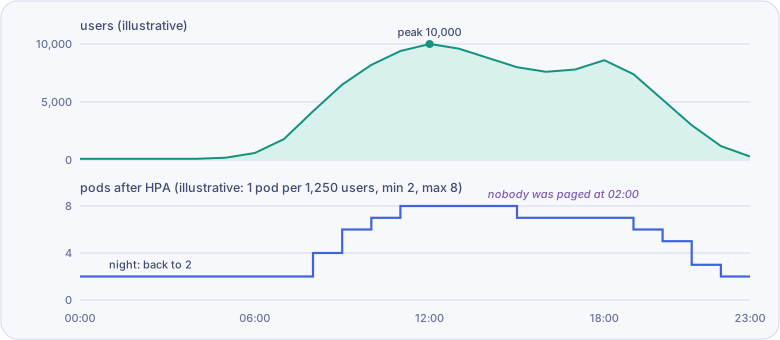 示意資料,不是實測。兩張圖共用時間軸,各自有自己的 y 軸。
給大人的。 第 6 步和第 11 步是同一課,只是從兩個方向講:Pod 只有在它需要記住的東西都放在別處時,才是真的可以丟掉。我們自架的 GitLab 用 Helm 跑在 EKS 上,設定存在資料庫。叢集升級時 Pod 從零重建、把設定讀回來,回到原來的樣子。我從來不需要打開 GitLab 管理介面把設定點回去。如果一次升級要靠某個人記得該點哪裡,那個 Pod 從來就不是真的可以丟。
原文:I wish someone had explained Kubernetes to me like this
第四章:搬進大城市
故事。 管家把房子搬到一座叫 EKS 的大城市。客人先問城市地圖(Route 53)怎麼走,從一個大門(load balancer)進來,買東西的往左、吃飯的往右。食物放在上鎖的地窖,只有廚房打得開。
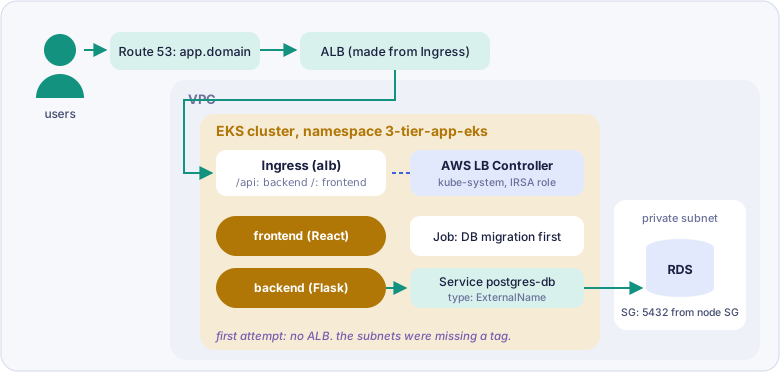
順序很重要:DB migration 用 Job 在 backend 啟動前跑完;AWS Load Balancer Controller 要先透過 OIDC(IRSA)拿到 IAM 角色,Ingress 才變得出 ALB。
給大人的。 我自己搬上 EKS 的那次,完全沒有 Ingress。舊架構是 reverse-proxy 叢集直接把流量送到每個部署的 apache2 instance,microservice 被釘死在那台機器上,沒辦法水平擴充。我加了一層間接:reverse proxy 改成全部送到一個內部 ALB,由它按 subdomain 分到各個 target group。Target group 不在乎後面是 EC2 instance 還是 Kubernetes Service,所以我用 TargetGroupBinding 把每個新的 Service 綁進原本的 target group,一個服務一個服務切過去。Reverse-proxy 團隊和應用程式團隊都不需要知道底下換了,microservice 也透過 HPA 拿到了水平擴充。多一跳的代價大約 50 ms,量過、接受了。這是基礎設施層的 strangler fig:應用程式不應該需要知道自己正在被搬家。
原文:Kubernetes real-world project, part 1
第五章:幫大門裝鎖
故事。 城市想幫每扇門裝鎖。鎖匠只把鎖給能證明房子是自己的人。所以一個叫 cert-manager 的小幫手在城市地圖上釘一張紙條,鎖匠看到紙條,鎖就送來了。小幫手還會在鎖用壞之前回來換新的。
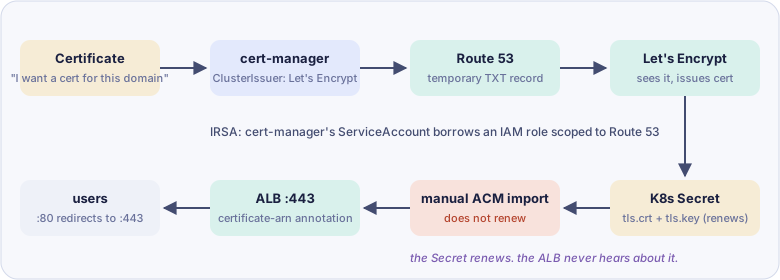
給大人的。 原文最後說 cert-manager 會自動續約憑證。它續的是 Kubernetes 裡的 Secret。可是 ALB 讀的是你手動匯入 ACM 的那一份,那一份不會知道續約這件事。Let’s Encrypt 憑證效期很短,所以這個做法裡藏了一個安靜的到期日。
我們的 reverse-proxy 叢集是反過來解同一個問題:把 TLS termination 移到 ALB,憑證只在 ACM 放一份,後端 instance 只看到 HTTP。每台機器各放一份憑證的麻煩就整個消失了。如果 load balancer 本來就是 AWS 管的,ACM 簽發的憑證是比較簡單的路。
原文:Kubernetes real-world project, part 2
第六章:日記和體溫計
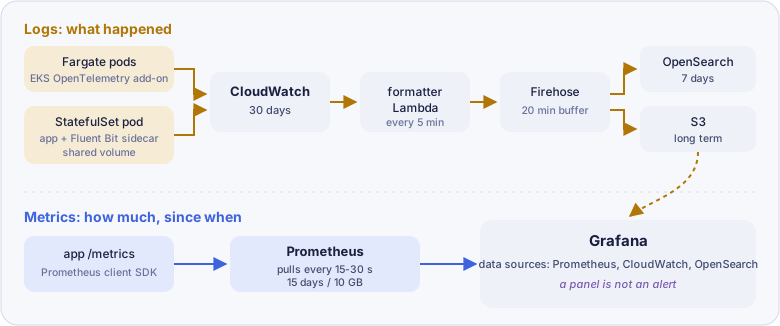
故事。 睡前,城市要寫兩樣東西。日記寫今天發生了什麼。體溫計整天每隔幾秒量一次有多熱。只有日記的話,你知道發燒了,卻不知道從什麼時候開始。
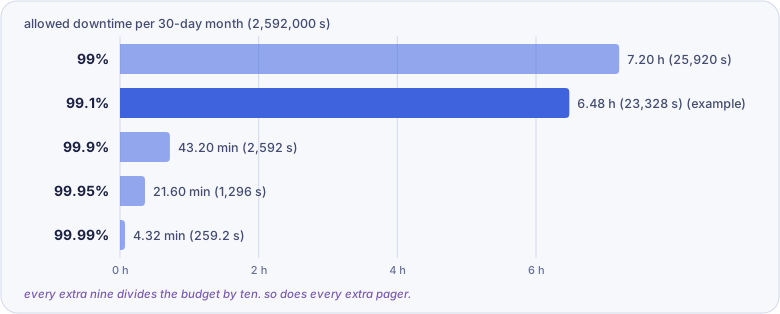 30 天的月份是 2,592,000 秒。99.1% 的額度是 23,328 秒,約 6.48 小時。
給大人的。 我做過最有用的體溫計,是一支客戶看不到的。monitor.py 每三分鐘對每個叢集用 HTTPS 登入、跑幾個簡單操作。我刻意把它放在 retry 那一層的下面,因為 retry 會吸收掉你最需要看到的壓力。它原本是為了另一種故障做的(見第七章),後來卻開始出現沒有任何 dashboard 解釋得了的零星錯誤。
那些錯誤的時間點,和 Aurora 使用率、IO latency 的尖峰對得起來。往 log 裡挖,挖出每天超過 6,000 個被前端 retry 藏起來的後端 timeout;面向客戶的成功率從頭到尾都在 SLA 內。應用程式開連線不做 pooling,重寫二十幾個服務不可行,所以 ProxySQL 放在基礎設施層:5,000 條靜態連線變成 29 條持久連線,P95 在 5 ms 內的查詢從 53% 變成 87%,timeout 消失,應用程式一行都沒改。
那些 timeout 的 panel 其實一直都在,只是沒人幫它接 alert。所以第二個修正是把 Grafana alert 從 UI 裡、也從我腦袋裡搬出來:Helm template、ConfigMap sidecar,十二條規則分兩個 PR 進 Git,每條都標成 provisioned,沒人能手動改到漂掉。
原文:How I set up monitoring for real microservices on EKS
第七章:Pod 晚上要睡哪間酒吧?
故事。 鎮上有三間酒吧。其中一間門口掛著牌子:只限邀請。有些 Pod 帶著邀請函,可是邀請函不會帶你過去,只會讓你進得去。所以鎮上把那間酒吧變成熱門店,帶邀請函的 Pod 就都想去了。熱門店客滿的時候,死腦筋的在門外等一整晚,隨和的就去別間。
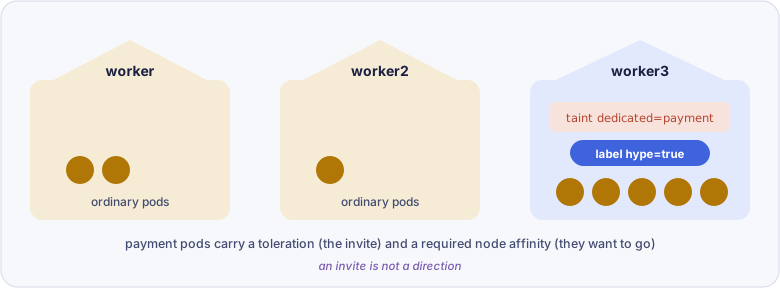
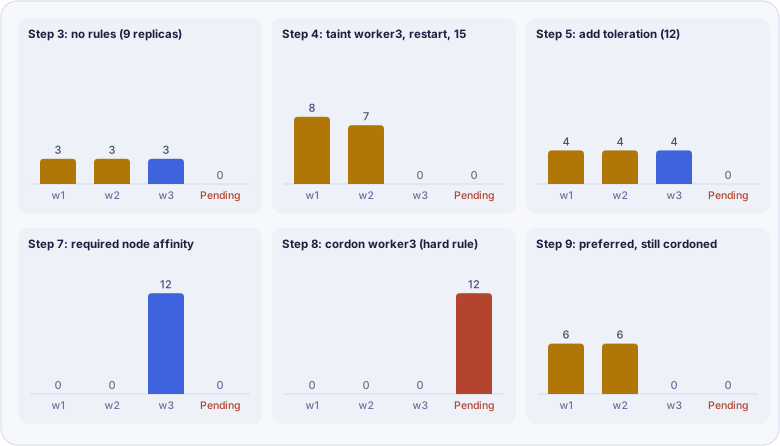 示意,依原文 lab 的描述畫的,每次實際數字會有些差。
| 機制 | 放在 | 做什麼 |
|---|---|---|
| Taint | Node | 沒有對應 toleration 的 Pod 進不來(NoSchedule 只擋新的,NoExecute 連在跑的都趕走) |
| Toleration | Pod | 允許進去,不會把 Pod 送過去 |
| Node affinity | Pod | 把 Pod 吸到有 label 的 node;required 可能卡 Pending,preferred 會退而求其次 |
| Pod affinity | Pod | 放在某些 Pod 旁邊(常聊天的一對,少一點跨 zone 流量) |
| Pod anti-affinity | Pod | 讓副本分開,一台 node 倒了不會全倒 |
給大人的。 「在門外等一整晚」不是假設。在用 Karpenter 之前,我們的 EKS node 跑在台北 local zone,instance type 選擇少、需求又高。要的型號拿不到時,叢集就只是等。沒有東西 crash、沒有東西重啟、沒有人被 page。Pod 停在 Pending,服務就這樣安靜地不再長大。monitor.py 就是為了這種安靜的故障而存在的。後來 Karpenter,以及真正的台北 region(ap-east-2)上線,從結構上把問題拿掉。我留下的教訓是:對稀缺資源下硬性排程限制,等於事先批准了一次停機。
原文:Kubernetes doesn’t care where your Pods land
第八章:Pod 不肯起床的那一晚
故事。 有一晚,十五個 Pod 都不肯下床。五個大人猜了兩個小時。答案是:有人把通往商店的路拆了,Pod 沒辦法去買衣服。寓意是:不要猜,每次都照同一個順序看。
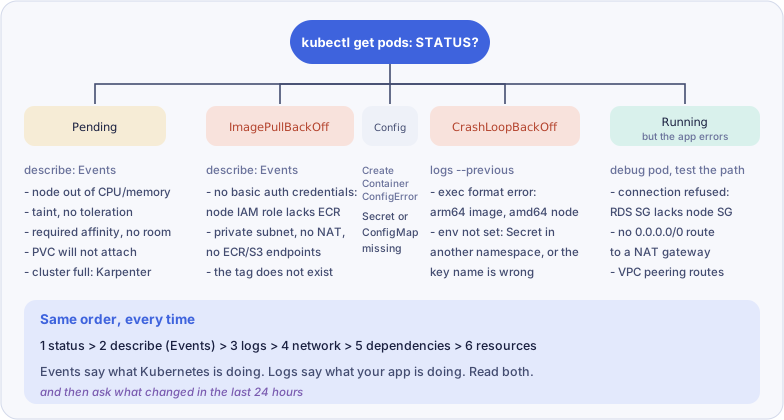
給大人的。 我信任的順序,比原文多了第零步:先止血。 在 E2 Nova,有一支新上線的 API 一直洩漏 file descriptor,直到整個服務用光。對使用者的修法不等於對 bug 的修法:我先在 gateway 把那一支 API 關掉,其他 endpoint 都還活著,leak 之後再查。停機不會等你,root cause 會。
原文最後的故事是一顆快壞的硬碟造成隨機的 CrashLoopBackOff;我的筆記裡有它的表兄弟:一次 MySQL ENUM 改名,觸發整張表重寫、拿住 metadata lock,整個平台卡了六十分鐘。二十個 microservice 看起來都壞了,真正有問題的只有資料庫。後來的修正是:每次 schema migration 都要先跑過一份 production 大小、已去識別化的 clone,並在 pull request 裡檢查 ALGORITHM=COPY 的風險。
原文:Kubernetes troubleshooting scenarios
第九章:工具箱
故事。 管家的工具間裡,每把工具都記得自己被需要的那一天。榔頭記得那塊鬆掉的木板,手電筒記得停電的那一晚。沒有人是為了把工具間塞滿才買工具的。
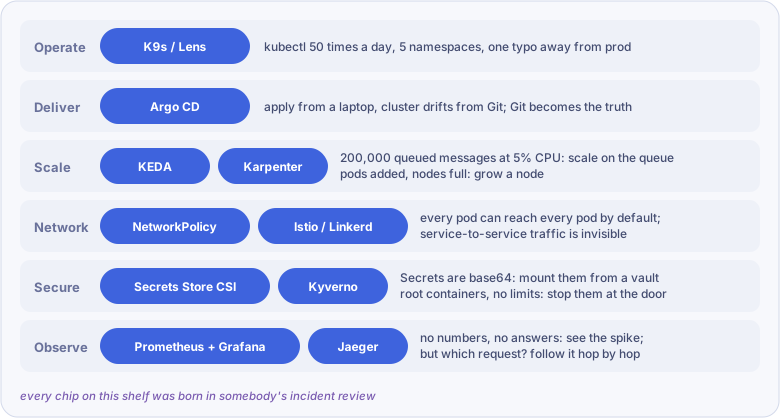
給大人的。 這裡有一把是我需要、卻沒有的。我們在 EKS 上的後端 container 是用 root 跑的,這是從 embedded 開發帶過來的習慣,在那個世界 root 很正常。我知道,但在任內沒有在 admission 層強制 runAsNonRoot。在受監管的環境,這是第一天就該有的控制:Kyverno 或 Gatekeeper 擋掉 root container,還在搬遷中的舊 workload 走明確的例外流程。把缺口寫下來也是工作的一部分;只列出有的工具、不列出缺的那把,工具架就只是一份型錄。
原文:The Kubernetes ecosystem has a story
第十章:睡前的五個問題
故事。 聰明的貓頭鷹睡前會問五個問題。每一題都有一個偷懶的答案,你一說貓頭鷹就知道。
| 問題 | 偷懶的答案 | 貓頭鷹想聽的 |
|---|---|---|
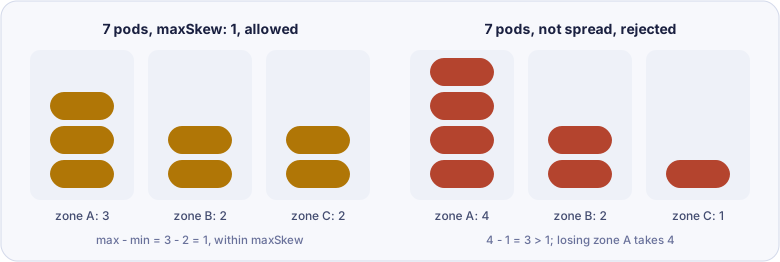
| Node 死了怎麼辦? | K8s 會重新排 | 事前就分散副本(topologySpreadConstraints:zone 硬、node 軟),計畫性 drain 用 PodDisruptionBudget 保護 |
| Black Friday 要來了 | HPA 會處理 | 用約 2 倍預期流量壓測,事前 pre-scale 到約 1.5 倍,queue 用 KEDA、node 用 Karpenter,DB、cache、CDN 也要一起規劃 |
| 線上起火了 | 看 log | Ack、在 dashboard 鎖定時間窗、看 Events、只查那個服務那段時間的 log、跟著 trace ID 走、問最近改了什麼 |
| 延遲太高 | 加副本 | 常聊天的服務放一起、優先同 zone(trafficDistribution: PreferClose),再去修 DB 那段路 |
| 規劃多 region | 開兩座叢集 | EKS 是 region 級資源;每個 region 一座叢集,前面一個全域入口,DB 一次只有一個 writer,通常 active-passive |
給大人的。 多 region 這題我只能講 failover,因為我們跑的就是 failover。東京是主站,台北 region 是我帶著建起來的。每年的 DR 演練把整條路走一遍:備援 region 的 ASG 擴起來、Aurora replica promote、驗證跨 region 的 S3 還原、用 Route 53 health check 切流量。外部稽核連續三年審過。Active-active 能換到更短的恢復時間,代價大約是兩倍成本;對那個平台來說,failover 是誠實的取捨。
原文:If you can answer these 5 Kubernetes questions
番外:Kubernetes 公司
故事。 每間公司都有兩種人。管理層不做實際的工作,只確保工作會發生;員工做真正的事。前台檢查識別證,帳本記得每一件事,盯場的人確保答應的人數都在位子上,派工的人找空桌子。每一個人會被找進來,都是因為少了他公司就運作不下去。
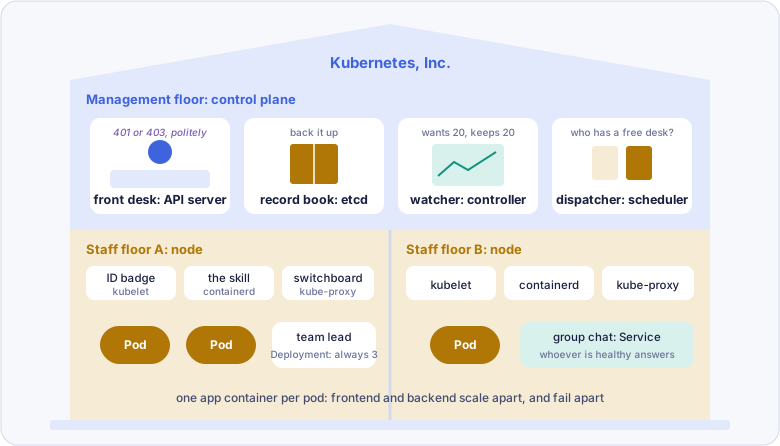
給大人的。 平台團隊能給的最便宜的禮物,是「今晚有一間自己的房間」。我們的後端工程師以前跑 unit test 要用兩套長得不一樣的 Docker 設定,一套在 CI、一套在筆電。我把兩套換成同一份 Kubernetes manifest,本機跑在 Minikube、CI 跑在 Jenkins 加 EKS。每次執行有自己的 namespace,名字帶一個 UUID,裡面是全新的 MySQL 和 MongoDB,測完就刪,跑在 Karpenter 的 spot 機器上。同一台筆電可以兩個 branch 並排測,互不干擾。本機和 CI 之間的落差不是變小,而是不存在了,因為只剩下一份定義。
原文:You will never forget how Kubernetes works after reading this
關於原文的幾個註記
這個系列寫得很好,下面都是小地方。會寫出來,是因為簡化不應該讓讀者做出不一樣的決定。
- Controller 和 scheduler 不直接說話。 Controller 建出一個還沒指定 node 的 Pod object;scheduler 看到後把 node 寫回去;kubelet 再把它開起來。全部經過 API server,原文 Part 2 自己也這樣寫。
- kube-proxy 不負責所有網路。 跨 node 的 Pod 對 Pod 流量是 CNI plugin 的工作(EKS 上是 AWS VPC CNI)。kube-proxy 管的是 Service 虛擬 IP 背後的轉送規則。
- ALB 的子網 tag。 公開的 ALB 要在 public subnet 貼
kubernetes.io/role/elb=1;kubernetes.io/role/internal-elb=1是給 private subnet 上的內部 load balancer。原文實際的指令用的是對的,內文寫成另一個。 - 匯入 ACM 的憑證不會跟著 cert-manager 續約(第五章)。
- Secrets Manager 的 init container 範例 把 volume 命名成
emptyDir,但 container 掛的是secrets,照抄會失敗。Part 9 的 Secrets Store CSI Driver 是比較乾淨的做法。 - 檢查 image 架構。
aws ecr describe-images --query imageScanFindingsSummary回的是弱點掃描結果,不是架構;要看架構用docker manifest inspect。
晚安
如果今晚只記得一件事:Kubernetes 不是一份要背的 object 清單,而是一串問題,每一個都由下一個 object 解決。下次出現一個新工具,先問它是從哪個問題生出來的。如果沒人說得出來,你大概還不需要它。